网页爬虫:如何从网站采集数据
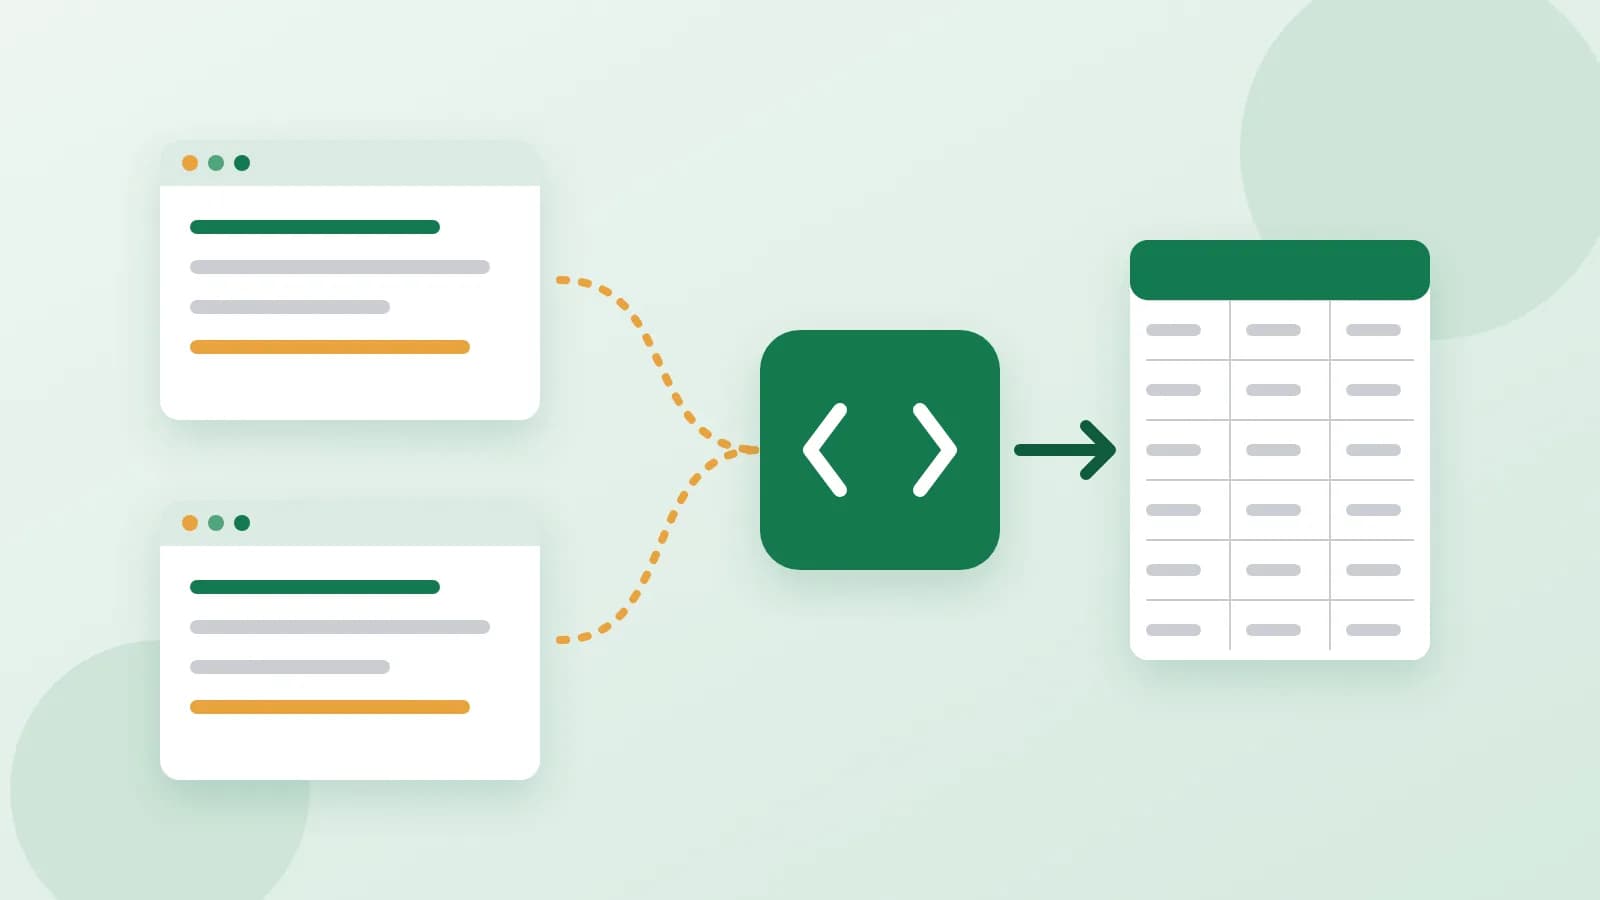
把供应商网站上的价格手动抄进表格,二十个商品还行。换成两千个,就要耗上一周,而且还会有错漏。网页爬虫(也叫采集程序)是一个小程序,它替您打开页面,从每个页面中提取相同的信息,并保存成表格。下面介绍它能做什么、需要准备什么,以及要遵守哪些规则。
爬虫适合做什么
只要同类信息分布在许多相似的页面上,爬虫就能派上用场:
- 价格和库存。 跟踪供应商的价格变化,或者哪些商品已经缺货。
- 供应商的商品目录。 把名称、描述、图片和价格搬到您自己的店铺。
- 信息列表。 从公开的信息平台上把房源、车源或招聘信息汇总到一张表里。
- 活动和文章。 从公开的日历或新闻页面收集日期、标题和链接。
只采集允许采集的数据
首先,确认这些数据可以正当获取:
- 只限公开页面。 如果需要登录才能看到数据,爬虫就不是合适的工具。
- 阅读网站的使用条款。 很多网站会写明哪些内容可以采集、哪些不可以。大型平台、搜索引擎和社交网络通常禁止采集;请改用它们的官方导出功能或 API。
- 遵守访问频率限制。 每个页面之间暂停几秒钟,可以减轻网站的负担。切勿试图绕过验证码或封禁。
- 遵守隐私法律。 个人的姓名、邮箱和电话号码属于个人数据,许多国家都对采集这类数据有严格限制。不要采集它们。
归根结底,您能否采集和使用某个网站的数据,由您自己决定,所以请在开始之前核实清楚。
描述页面
爬虫是根据页面的实际结构编写的,所以描述要准确:
- 一个列表页的链接和一个商品详情页的链接。
- **大约有多少页,**例如“约 40 个列表页,每页 24 个商品”。
- 用浏览器保存的一两个页面(文件 > 网页另存为)或页面截图。
像表格的列一样列出字段
把结果想象成一张电子表格,按顺序写出各列的名称,每列附一个示例:
- 名称: “橡木砧板,大号”
- 价格: “34.90”
- 原价: “39.90”,如果商品在打折
- 有货: “是”
- 商品页链接和图片链接
十个清晰的字段胜过三十个含糊的字段。加上您需要的任何规则,例如“只要有货的商品”。
选择格式和运行方式
- CSV 可以用任何电子表格软件打开,也能导入大多数店铺系统。
- Excel 更方便您手动筛选和排序。
- JSON 适合要把数据加载到其他地方的开发人员。
爬虫用 Python 在您自己的电脑上运行,数据直接到您手中,需要最新数据时可以随时重新运行。
当网站发生变化时
爬虫是按照页面现在的样子编写的。如果网站改版,爬虫可能就找不到字段了,需要更新。即使访问节奏很温和,网站也可能限制访问次数。如果您每周都依赖这些数据,请提前做好准备。
总结
确定您需要哪些公开页面和字段,查看网站的使用条款,保持温和的访问节奏,并且不要采集个人数据。如果您不想自己写代码,可以订购网页爬虫:您发送网站、字段以及一两个保存好的页面,即可收到 Python 代码、一个配置文件和一份分步运行指南,把数据导出为 CSV、Excel 或 JSON。只有在您验收后才会放款。