ZahlungsschutzMehr dazu
- Überarbeitungen im Rahmen des Pakets sind kostenlos.
- Reagieren Sie nicht innerhalb von 3 Tagen nach der Lieferung, gilt die Arbeit automatisch als abgenommen.
Das Geld wird bei der Zahlung reserviert und erst freigegeben, wenn Sie die Arbeit abnehmen.
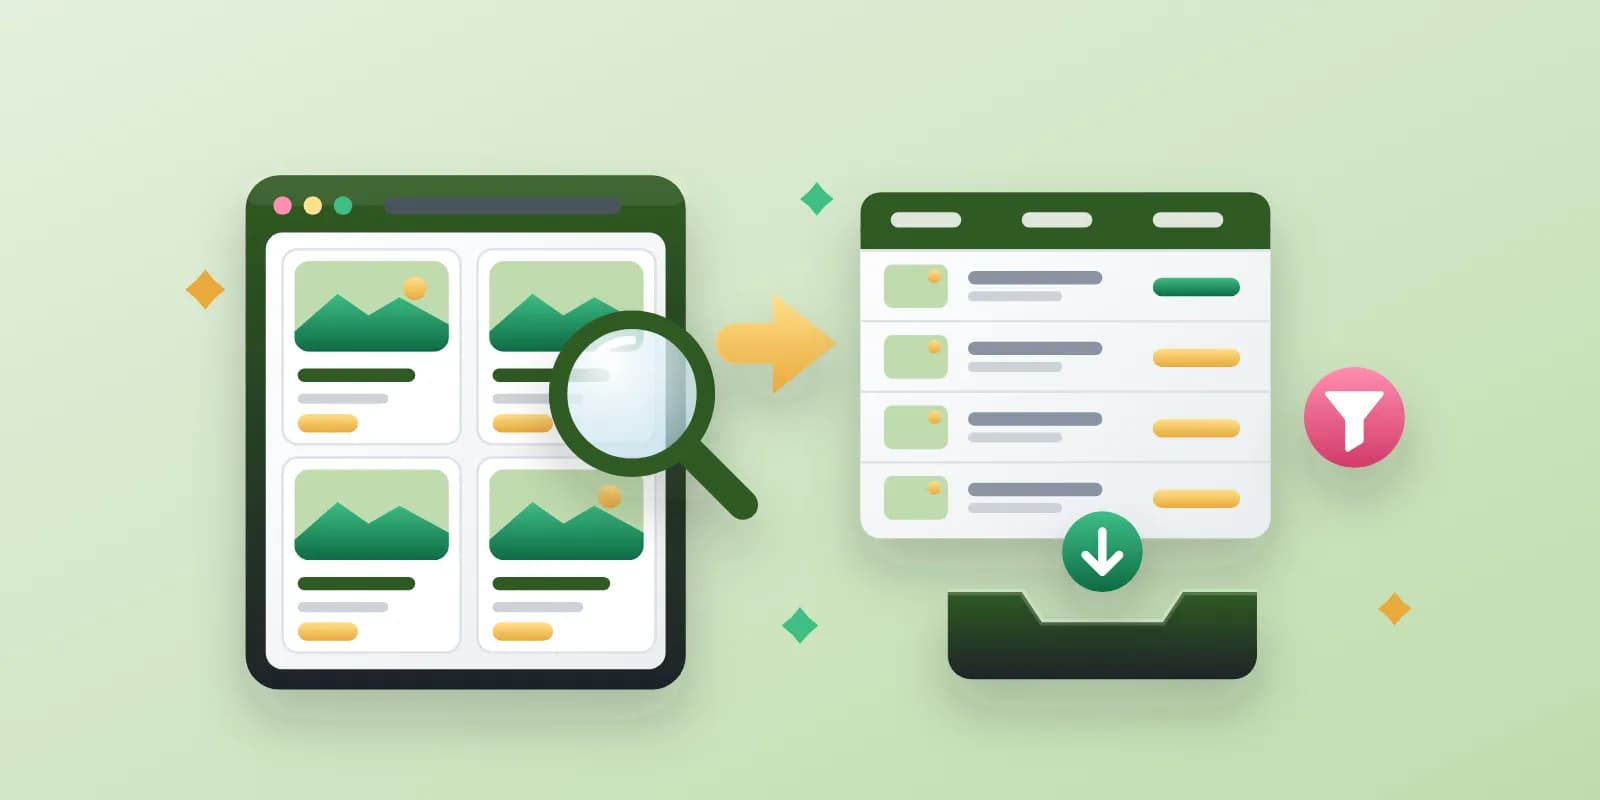
Beispielergebnis
Parser für den Katalog eines Gartengeräte-Lieferanten nach Excel
So sieht das Ergebnis aus
| Artikelnr. | Bezeichnung | Preis | Verfügbar | Gewicht | Foto |
|---|---|---|---|---|---|
| GT-1042 | Gartenschere, 20 mm | 18,90 | Ja | 0,24 kg | …/gt-1042.jpg |
| GT-1187 | Klappsäge, 210 mm | 24,50 | Ja | 0,31 kg | …/gt-1187.jpg |
| GT-2210 | Heckenschere, Wellenschliff | 39,00 | Nein | 1,10 kg | …/gt-2210.jpg |
| GT-3305 | Handschaufel, Edelstahl | 9,80 | Ja | 0,18 kg | …/gt-3305.jpg |
| GT-4120 | Gartenschlauch 25 m, 1/2" | 42,00 | Ja | 2,90 kg | …/gt-4120.jpg |
Die Datei im Beispiel enthält 1.236 Produkte von 52 Listenseiten.
Ein Teil des Codes
def product_links(list_url: str) -> Iterator[str]:
    """Links zu den Produktseiten von jeder Seite der Liste, dem Link „Weiter“ folgend."""
    url: str | None = list_url
    while url:
        page = fetch(url)
        for card in page.select("div.product-card a.title"):
            yield urljoin(url, card["href"])
        next_link = page.select_one("a.pagination-next")
        url = urljoin(url, next_link["href"]) if next_link else None


def fetch(url: str) -> BeautifulSoup:
    """Eine öffentliche Seite in höflichem Tempo: eine Pause zwischen Anfragen und einige Versuche bei Fehlern."""
    for attempt in range(3):
        time.sleep(settings.delay_seconds)
        response = session.get(url, timeout=30)
        if response.status_code == 200:
            return BeautifulSoup(response.text, "html.parser")
        log.warning("%s antwortete mit %s, Versuch %d von 3", url, response.status_code, attempt + 1)
    raise ScraperError(f"{url} ließ sich nach 3 Versuchen nicht öffnen")
Dateien: ein ZIP-Archiv mit scraper.py, settings.ini (die Startseite, die Pause zwischen Anfragen, der Dateiname), requirements.txt und einer README zu Installation und Start. Er liest nur öffentlich zugängliche Seiten, eine alle 2 Sekunden, und prüft zuerst die robots.txt der Website. Der Kunde startet ihn auf seinem eigenen Computer.
Kunde: ein Online-Gartenshop, der die Geräte eines Lieferanten weiterverkauft; der Lieferant hat einen öffentlichen Katalog auf seiner Website, aber keine Preislistendatei. Aufgabe: die Listenseiten des Katalogs durchlaufen, jede Produktseite öffnen und Artikelnummer, Bezeichnung, Preis, Verfügbarkeit, Gewicht und den Link zum Hauptfoto in Excel speichern, um einmal pro Woche die Preise zu vergleichen.
Kunde und alle Angaben sind erfunden.
Über diese Leistung
Ein Parser sammelt Daten, die Sie auf öffentlichen Webseiten sehen können, und speichert sie als Tabelle: Preise und Bestand von Produkten, den Katalog eines Lieferanten für Ihren Shop, Anzeigen, Stellenangebote, Veranstaltungen oder Artikel. Nennen Sie uns die Website und die Seiten, listen Sie die benötigten Felder auf (Name, Preis, Link, Bild und so weiter) und schicken Sie ein oder zwei dieser Seiten, aus Ihrem Browser gespeichert (Datei > Seite speichern unter), oder Screenshots davon. Wir schreiben den Parser in Python nach der tatsächlichen Struktur dieser Seiten, und er speichert die Ergebnisse als CSV, Excel oder JSON. Sie erhalten ein Archiv mit dem Code, einer Einstellungsdatei mit den Adressen und der Pause zwischen den Seiten und einer README, die erklärt, wie Sie Python installieren und den Parser starten. Sie starten den Parser auf Ihrem eigenen Computer, sodass die Daten direkt zu Ihnen gelangen; wir sammeln sie nicht für Sie und bewahren sie nicht auf. Er liest nur öffentlich zugängliche Seiten in höflichem Tempo, meldet sich nie an, umgeht keine Captchas oder andere Schutzmaßnahmen und sammelt keine personenbezogenen Daten wie Namen, E-Mail-Adressen oder Telefonnummern von Personen. Wenn eine Website ihren Aufbau ändert, braucht der Parser unter Umständen eine Aktualisierung. Ob Sie die Daten einer Website nach deren Nutzungsbedingungen sammeln und nutzen dürfen, liegt in Ihrer Verantwortung.
Was enthalten ist
- Das erhalten SieEin ZIP-Archiv mit dem Python-Code, einer Einstellungsdatei und einer README mit Schritt-für-Schritt-Anleitung; der Code wird auch auf der Bestellseite angezeigt.
- Ihre Felder, Ihre TabelleSpalten in der Reihenfolge, die Sie brauchen
- Auf Basis der echten Seiten gebautNach der Struktur der Seiten geschrieben, die Sie schicken
- Höfliches TempoEine Pause zwischen den Seiten, in den Einstellungen festgelegt
- Läuft auf Ihrem ComputerWindows, macOS oder Linux, mit Python
- Eine verständliche AnleitungWas installiert wird und wie man ihn startet, Schritt für Schritt
So funktioniert es
- 1SeitenSie nennen die Website, die Felder und ein oder zwei gespeicherte Seiten
- 2ParserWir schreiben den Code und die Anleitung zum Ausführen
- 3StartSie starten ihn und prüfen die ersten Zeilen der Tabelle
- 4ÜberarbeitungenSie wünschen Überarbeitungen im Rahmen Ihres Pakets und schicken etwaige Fehlermeldungen
Was wir von Ihnen brauchen
Die Website und die genauen Seiten: ein Link zu einer Liste und zu einer Detailseite und ungefähr wie viele Seiten es gibt. Die benötigten Felder in der Reihenfolge Ihrer Tabelle, mit einem Beispiel für jedes. Ein oder zwei dieser Seiten, aus Ihrem Browser als HTML gespeichert (Datei > Seite speichern unter), oder Screenshots, damit der Parser ihrer tatsächlichen Struktur folgt. Die gewünschte Ergebnisdatei (CSV, Excel oder JSON) und wo Sie ihn starten werden.
Wir fragen Sie:
- Welche Website und welche Seiten?
- Die benötigten Felder
- Ungefähr wie viele Seiten?
- Die Ergebnisdatei
- Was er sonst noch tun soll
Pakete vergleichen
| Pakete | BasisParser für einen Seitentyp23 € | StandardListen- und Detailseiten44 € | PremiumMehrere Websites oder Seitentypen79 € |
|---|---|---|---|
| Lieferzeit | 1 Tag | 2 Tage | 3 Tage |
| Überarbeitungen | 1 | 2 | 3 |
| Websites | 1 | 1 | bis zu 3 |
| Seitentypen | 1 | 2 (Liste und Detailseite) | bis zu 3 |
| Felder | bis zu 10 | bis zu 25 | bis zu 25 pro Seitentyp |
| Durchläuft die Seiten einer Liste | Nein | Ja | Ja |
| Ergebnisdatei | CSV | Excel oder CSV | Excel, CSV oder JSON |
| Duplikate entfernt, setzt dort fort, wo er aufgehört hat | Nein | Nein | Ja |
| Bestellen Basis | Bestellen Standard | Bestellen Premium |
Zahlungsschutz
Sie bezahlen bei der Bestellung, aber das Geld wird nur für abgenommene Arbeit freigegeben.
- FestpreisDer Paketpreis ändert sich nach der Zahlung nicht mehr.
- Das Geld wird reserviertBei der Zahlung wird der Betrag nur reserviert. Freigegeben wird er erst, wenn Sie die Arbeit abnehmen.
- Vor der Lieferung geprüftJedes Ergebnis durchläuft eine Qualitätsprüfung, bevor es Sie erreicht, und Sie sehen es auf der Bestellseite, bevor Sie es abnehmen.
- Kostenlose ÜberarbeitungenFordern Sie Überarbeitungen im Rahmen Ihres Briefings so oft an, wie das Paket es erlaubt.
- Abnahme nach 3 TagenWenn Sie die Arbeit innerhalb von 3 Tagen nach der Lieferung weder abnehmen noch eine Überarbeitung anfordern, gilt sie automatisch als abgenommen. Schreiben Sie nach der Lieferung im Bestell-Chat, wartet die Bestellung; sobald wir antworten, können wir die 3 Tage neu starten und teilen das im Chat mit.
- Neuanfertigung oder volle RückerstattungWenn das Ergebnis nicht Ihrem Briefing entspricht und die Überarbeitungen das nicht behoben haben oder die Arbeit mehr als doppelt so lange dauert wie die Frist, schreiben Sie im Bestell-Chat: Wir erstellen die Arbeit neu oder erstatten die Zahlung vollständig.
Fragen und Antworten
Ist es legal, eine Website zu parsen?
Das Sammeln öffentlicher Daten ist in vielen Fällen erlaubt, aber Nutzungsbedingungen von Websites und Datenschutzgesetze unterscheiden sich von Land zu Land, daher entscheiden Sie, ob Sie die Daten sammeln und nutzen dürfen. Der Parser meldet sich nie an, umgeht keine Schutzmaßnahmen und sammelt keine personenbezogenen Daten, was ihn auf der sicheren Seite hält.
Sammeln Sie die Daten für mich?
Nein. Sie erhalten den Parser und starten ihn selbst, sodass die Ergebnisse direkt zu Ihnen gelangen und Sie ihn jederzeit erneut starten können, wenn Sie frische Daten brauchen.
Was, wenn die Website sich ändert oder den Parser blockiert?
Der Parser arbeitet mit den Seiten, wie sie jetzt sind. Ändert die Website später ihren Aufbau, braucht der Parser eine Aktualisierung, die eine neue Bestellung ist. Er liest in höflichem Tempo, aber eine Website kann die Zugriffe trotzdem begrenzen; solche Begrenzungen umgeht er nicht.
Kann er Amazon, Google oder soziale Netzwerke parsen?
Nein. Deren Nutzungsbedingungen verbieten das Sammeln ihrer Daten auf diese Weise, viele ihrer Seiten erfordern eine Anmeldung, und sie enthalten personenbezogene Daten von Menschen. Für solche Daten nutzen Sie die offizielle API oder den Export des Dienstes.
Muss ich programmieren können?
Nein. Die README erklärt, wie Sie Python einmalig installieren, mit einem Befehl installieren, was der Parser braucht, und ihn starten. Für Seiten, die ihren Inhalt mit JavaScript aufbauen, nutzt der Parser eine Browser-Bibliothek (Playwright), die die README ebenfalls abdeckt.
Keine Antwort gefunden?