 Desenvolvimento
Parser de preços de livros
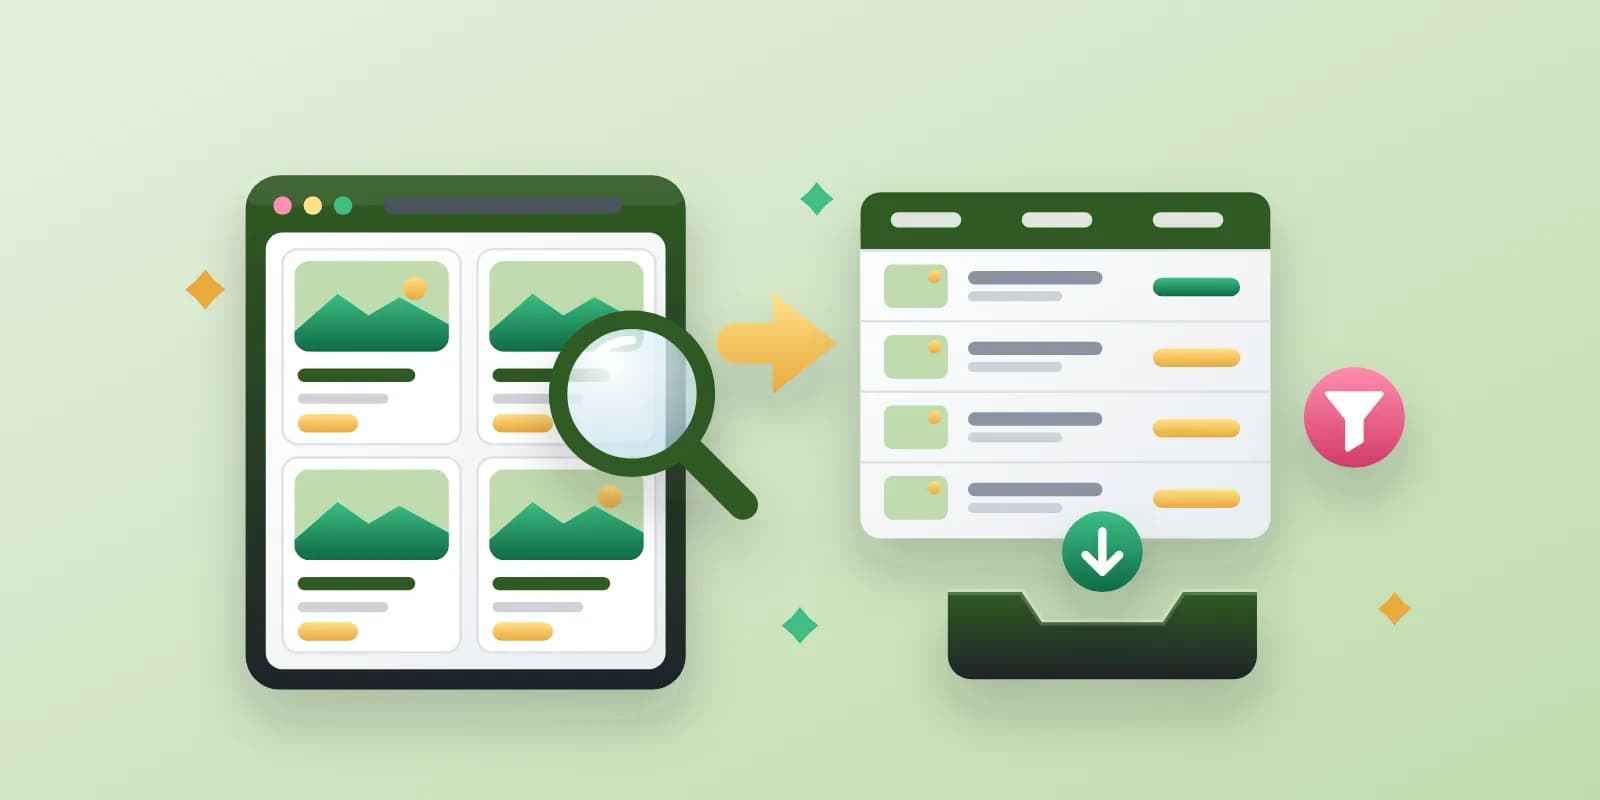
Um parser em Python que reúne preços abertos de livros em uma tabela: título, autor, ISBN, formato, preço e estoque
Preçoa partir de R$ 123
O dinheiro fica reservado no pagamento e só é liberado quando você aprova o trabalho.
| Artigo | Nome | Preço | Em estoque | Peso | Foto |
|---|---|---|---|---|---|
| GT-1042 | Tesoura de poda, 20 mm | 18,90 | Sim | 0,24 kg | …/gt-1042.jpg |
| GT-1187 | Serrote dobrável, 210 mm | 24,50 | Sim | 0,31 kg | …/gt-1187.jpg |
| GT-2210 | Tesoura para cerca viva, lâmina ondulada | 39,00 | Não | 1,10 kg | …/gt-2210.jpg |
| GT-3305 | Pá de jardinagem, inox | 9,80 | Sim | 0,18 kg | …/gt-3305.jpg |
| GT-4120 | Mangueira de jardim 25 m, 1/2" | 42,00 | Sim | 2,90 kg | …/gt-4120.jpg |
O arquivo do exemplo tem 1.236 produtos de 52 páginas de lista.
def product_links(list_url: str) -> Iterator[str]:
    """Links das páginas de produto de todas as páginas da lista, seguindo o botão 'Próxima'."""
    url: str | None = list_url
    while url:
        page = fetch(url)
        for card in page.select("div.product-card a.title"):
            yield urljoin(url, card["href"])
        next_link = page.select_one("a.pagination-next")
        url = urljoin(url, next_link["href"]) if next_link else None


def fetch(url: str) -> BeautifulSoup:
    """Uma página aberta, em um ritmo educado: uma pausa entre as requisições e algumas tentativas em caso de erro."""
    for attempt in range(3):
        time.sleep(settings.delay_seconds)
        response = session.get(url, timeout=30)
        if response.status_code == 200:
            return BeautifulSoup(response.text, "html.parser")
        log.warning("%s respondeu %s, tentativa %d de 3", url, response.status_code, attempt + 1)
    raise ScraperError(f"{url} não abriu depois de 3 tentativas")
Arquivos: um arquivo ZIP com scraper.py, settings.ini (a página inicial, a pausa entre as requisições, o nome do arquivo), requirements.txt e um README sobre como instalar e rodar. Ele lê só páginas abertas, uma a cada 2 segundos, e confere antes o robots.txt do site. O cliente roda o parser no próprio computador.
Cliente: uma loja online de jardinagem que revende as ferramentas de um fornecedor; o fornecedor tem um catálogo aberto no site, mas nenhum arquivo de tabela de preços. Tarefa: percorrer as páginas de lista do catálogo, abrir cada página de produto e salvar no Excel o código do artigo, o nome, o preço, o estoque, o peso e o link da foto principal, para comparar os preços uma vez por semana.
O cliente e todos os dados são fictícios.
Quem apresenta podcasts e está mudando para um site novo, editores de notas dos episódios e pesquisadores usam este parser para listar episódios em uma tabela: número, temporada, título, data, duração, descrição curta, temas ou tags, link para a página do episódio e o link do áudio quando a página mostra. Ele lê o próprio site aberto do programa, ou o feed RSS aberto, que a maioria dos podcasts tem. Envie a página da lista de episódios, uma página de episódio e uma ou duas páginas salvas no seu navegador. Você recebe o código em Python, um arquivo de configurações e um README e roda no seu computador. Ele salva links, não arquivos de áudio, e não tem coluna para nomes de convidados. Ele lê em um ritmo educado, nunca faz login nem contorna captchas ou proteções, e não lê redes sociais nem apps de áudio que exigem conta. Você decide se os termos do site permitem; uma mudança futura no layout exige uma atualização.
O site do podcast e um link para a lista de episódios, ou o endereço do feed RSS aberto, uma página de episódio e mais ou menos quantos episódios há. Os campos na ordem da sua tabela, ex.: número, temporada, título, data, duração, descrição, tags, link do episódio, link do áudio. Uma ou duas dessas páginas salvas no seu navegador (Arquivo > Salvar página como) ou capturas de tela. CSV, Excel ou JSON.
Vamos perguntar:
| Pacotes | BásicoEpisódios de uma listaR$ 117 | PadrãoPáginas de lista e de episódioR$ 229 | PremiumAté 3 podcastsR$ 412 |
|---|---|---|---|
| Prazo | 1 dia | 2 dias | 3 dias |
| Ajustes | 1 | 2 | 3 |
| Sites | 1 | 1 | até 3 |
| Tipos de página | 1 | 2 (lista de episódios e página de episódio) | até 3 |
| Campos | até 10 | até 25 | até 25 em cada |
| Percorre as páginas de uma listagem | Não | Sim | Sim |
| Arquivo de resultados | CSV | Excel ou CSV | Excel, CSV ou JSON |
| Duplicados removidos, retoma de onde parou | Não | Não | Sim |
| Fazer pedido Básico | Fazer pedido Padrão | Fazer pedido Premium |
Você paga ao fazer o pedido, mas o dinheiro só é liberado pelo trabalho aprovado.
Não. Os episódios pertencem a quem os produz, então o parser salva links para o áudio, não os arquivos.
Sim, se o feed estiver aberto em um endereço público. Ele conta como um tipo de página e muitas vezes traz datas e durações de forma mais organizada que o site.
Não. Apps que exigem conta, redes sociais, Google, Amazon e LinkedIn estão fora. O próprio site aberto ou o feed do programa funciona, desde que você decida que os termos permitem.
Não. Ele coleta o que já está escrito nas páginas; não ouve episódios nem escreve textos. Se o site mudar o layout depois, o parser precisa de uma atualização.
Não encontrou a resposta?
Desenvolvimento Desenvolvimento
 Desenvolvimento
 Desenvolvimento